Producto
Cada capa entre el usuario y la app, medida en el equipo
Un agente por equipo alimenta las vistas de cada equipo y de cada grupo, el mapa de tu flota, las alertas y tus propias herramientas. Donde una plataforma no puede medir algo, la consola lo dice en vez de mostrar un cero.
Hopix NPM
Tráfico y salud de las conexiones, por app
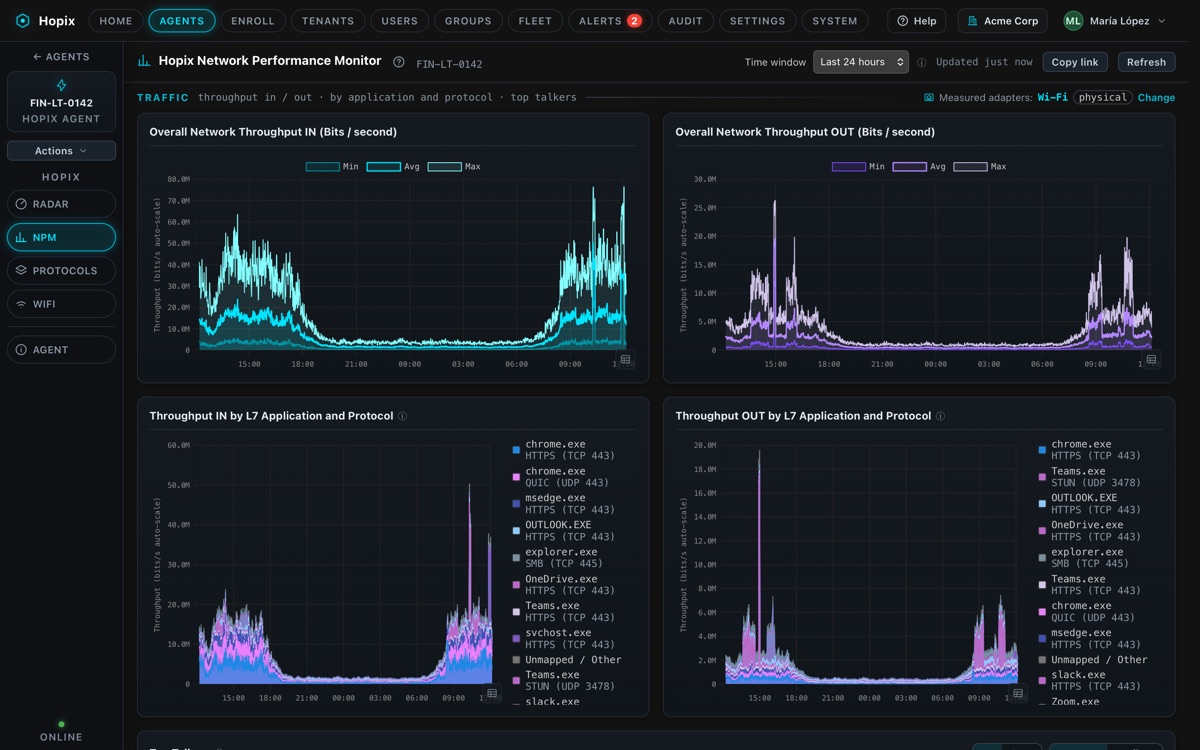
Rendimiento, latencia, retransmisiones, conexiones fallidas y tráfico descartado en el equipo, por app y por destino, minuto a minuto. Los hallazgos ordenados dicen qué mirar primero.
- Un resumen con los indicadores clave y los hallazgos ordenados
- Hallazgos de lo que es inusual para ese equipo a esa hora del día, frente a su propia historia
- Tráfico por app, servicio y destino, con filtros
- Si la demora está en la red o en la app
- Salud TCP: cuánto tardan en abrirse las conexiones, las que se caen por vencimiento y las rutas que descartan en silencio los paquetes grandes
- Cada conexión, a un clic del mapa de la flota
- Exportación a CSV de las tablas
Rangos de 15 minutos a 7 días, dentro de hasta 90 días de historial, según el plan.
Protocolos
Cada protocolo, como cliente y como servidor
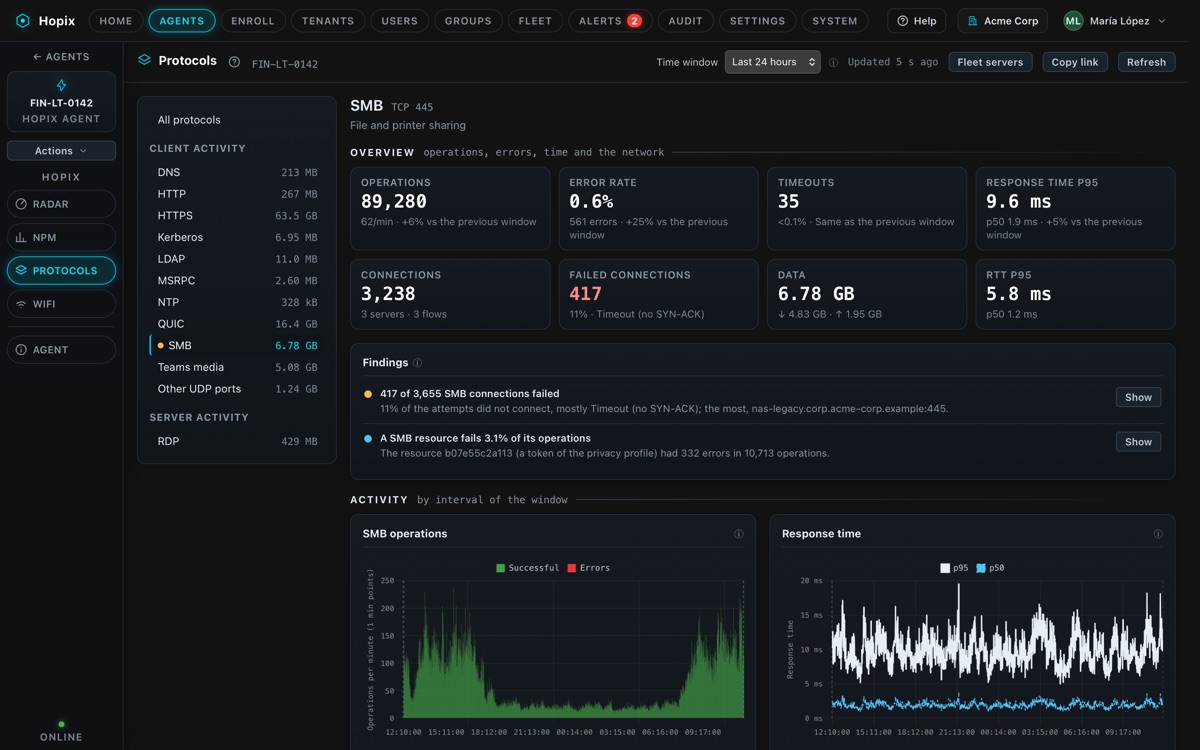
Una página por cada protocolo que el equipo usa o sirve, del DNS, HTTP y TLS a SMB, Kerberos, LDAP, RDP, SSH y las bases de datos. Cada una tiene un resumen, hallazgos que señalan el problema, su propio detalle, y los mismos gráficos que Hopix NPM, cada uno con su tabla.
- Cerca de 70 protocolos reconocidos de serie, separados en actividad como cliente y actividad como servidor
- Hallazgos por protocolo, como los reinicios y las conexiones fallidas en HTTPS, los errores de un recurso compartido o las respuestas lentas
- Operaciones, códigos de error, versiones y el tiempo de respuesta típico y el de las más lentas
- Páginas de las bases de datos, el correo, la transferencia de archivos, el acceso remoto y los protocolos industriales, con sus servidores y los puertos que viajan sin cifrar
- Una tabla debajo de cada gráfico, para ordenar, filtrar y exportar cada intervalo
- Tus propios servicios, nombrados una vez por su puerto, con su propia página en la vista de cada equipo
- Las mismas páginas para un grupo de equipos
- Alertas sobre las operaciones, la tasa de errores, los timeouts y el tiempo de respuesta de un protocolo, también cuando son inusuales para ese equipo
Cada página de protocolo, con su tráfico, sus conexiones, sus hallazgos y su actividad como servidor, funciona en Windows, macOS y Linux. Las operaciones, los códigos de error y los tiempos de respuesta dependen de lo que informa cada sistema: la mayoría salen de Windows, y algunos de macOS y de Linux. En macOS y Linux, decodificadores opcionales los suman para más de 20 protocolos, como SMB, Kerberos, HTTP, LDAP, SQL Server y MySQL, y los handshakes de TLS y QUIC; vienen apagados, y nuestro equipo los enciende cuando lo pidas. En Linux, una fuente opcional suma la calidad de cada llamada: la pérdida, el jitter y un MOS estimado.
Hopix DNS
Cuando el problema es el nombre
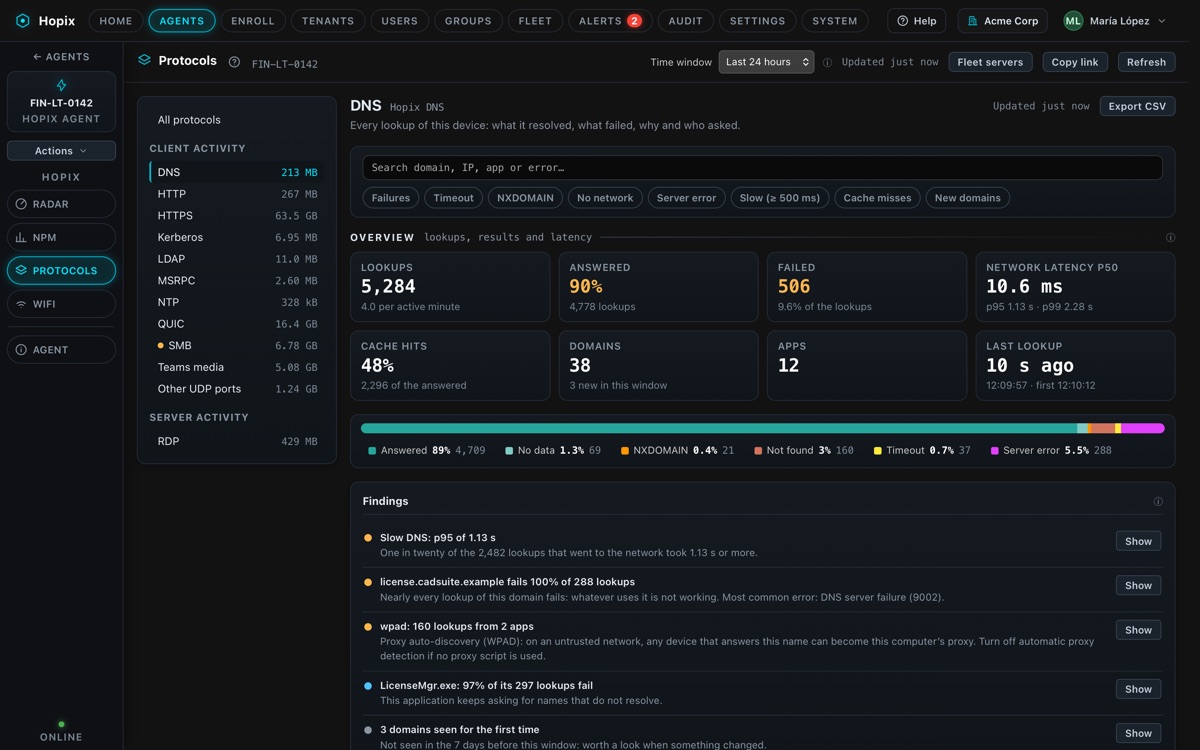
Cada consulta con su resultado y su latencia, por app y por dominio, comparada con la semana anterior. En la consola es la página de DNS de Protocolos.
- Hallazgos de dominios y apps que fallan, resolvers lentos y timeouts
- Señala las consultas sospechosas y las mal configuradas
- Detecta los dominios nuevos frente a la semana anterior
- Señala más consultas o más fallas que las habituales para ese equipo
- Filtros por resultado, dominio, app y latencia, y exportación a CSV
Rangos de hasta 90 días, según el plan.
Radar
La ruta, salto a salto, en vivo
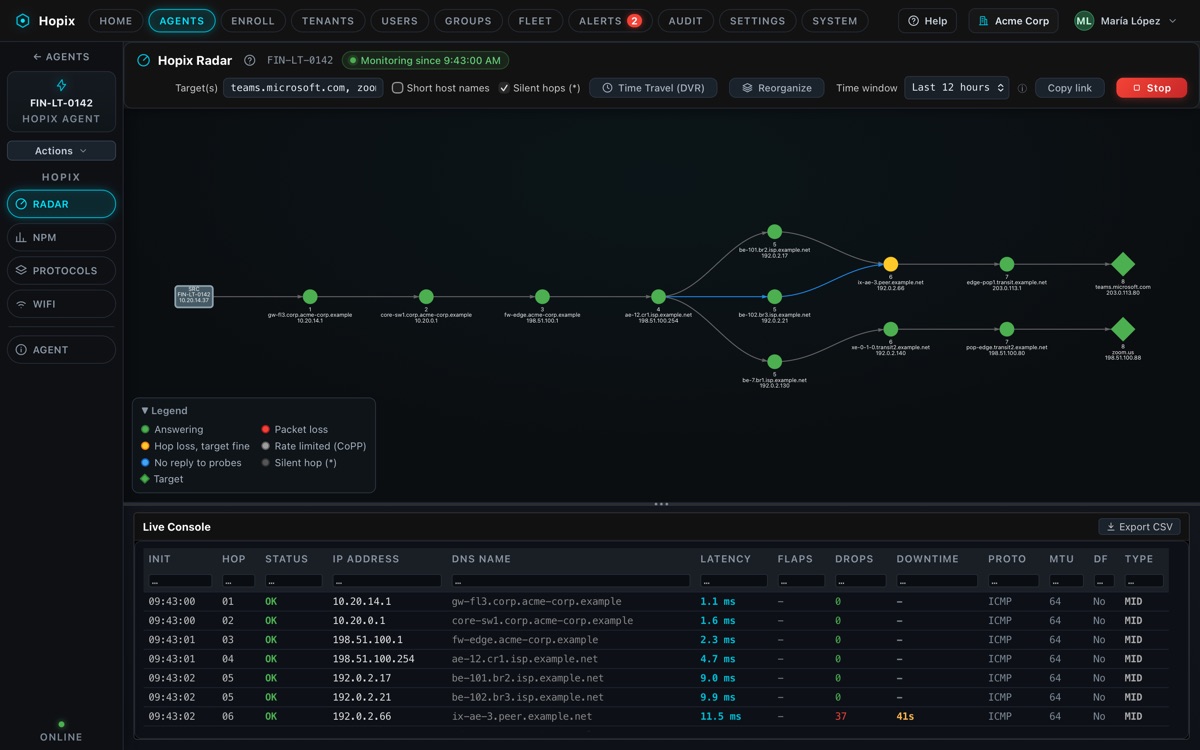
Inicia desde la consola una sesión hacia los destinos que elijas y mira cómo se dibuja la ruta: cada salto con su latencia, su pérdida y sus cambios.
- Mapa y tabla de saltos en vivo
- La latencia y la pérdida de cada salto en el tiempo
- Repetición de los últimos 7 días
Solo los administradores de agentes pueden iniciar una sesión, y cada inicio queda auditado.
Wifi
La radio, no solo las barras
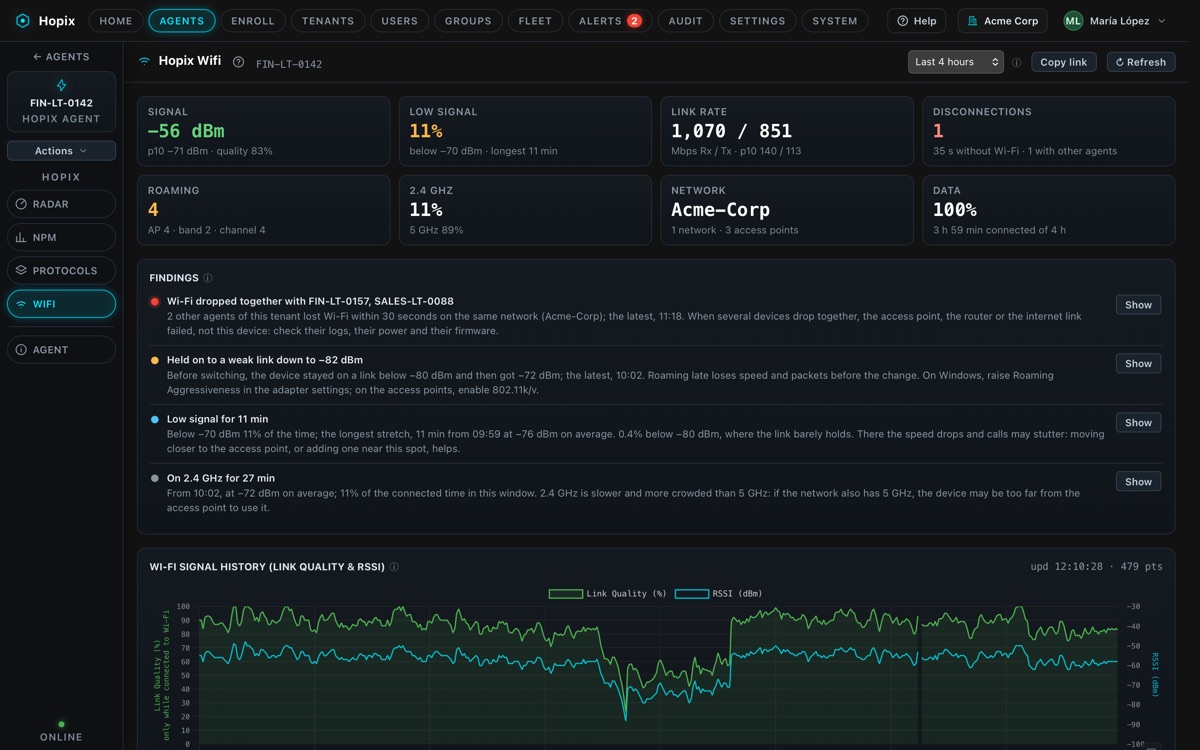
Señal y calidad del enlace, velocidad, banda y canal, roaming entre puntos de acceso y cada desconexión. Cuando otros equipos de la misma red se caen en el mismo momento, Hopix te dice que fue el punto de acceso o el router, no la laptop.
- Historial de la señal y velocidad del enlace
- Roaming y registro de eventos
- Hallazgos de caídas compartidas, problemas de roaming y señal débil
- Vista de la radio en vivo mientras la miras
- Historial de hasta 90 días, según el plan
En macOS no está disponible el ID del punto de acceso; el agente de Linux no tiene módulo de Wi-Fi.
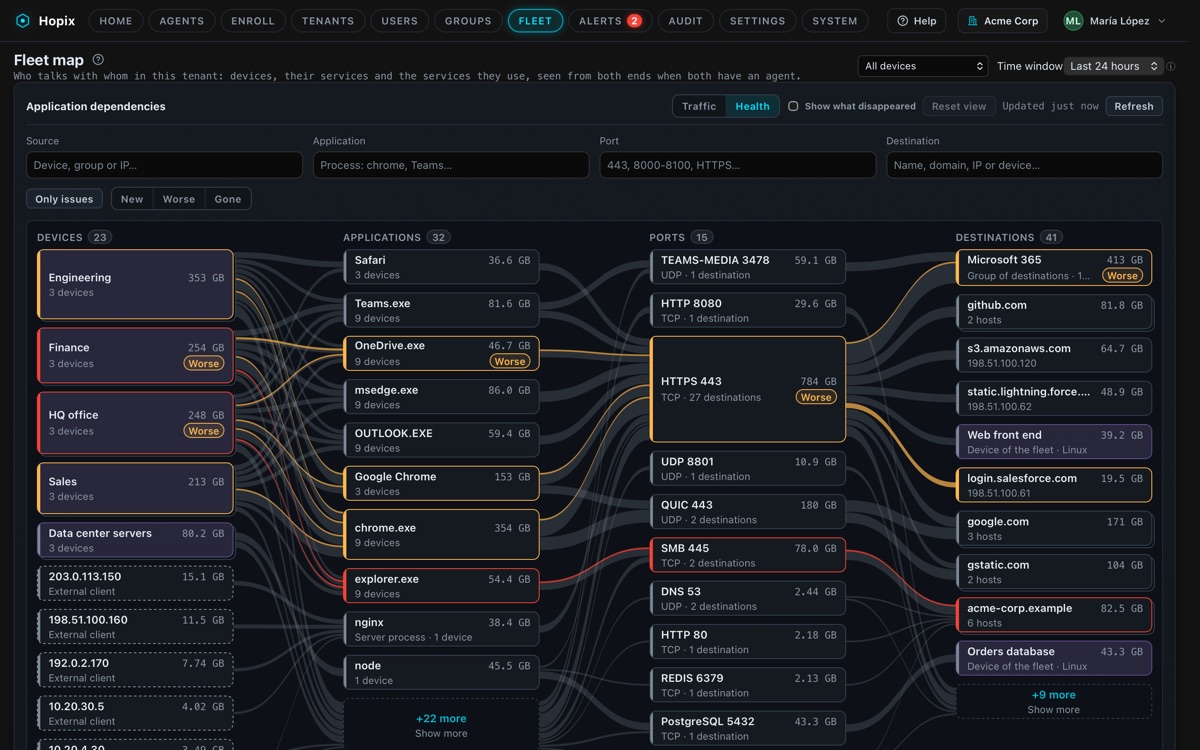
Mapa de la flota
Quién habla con quién, en toda la flota
Un mapa de dependencias del tenant, de un grupo o de un solo equipo: los equipos, sus procesos, los servicios que usan y los clientes de tus propios servidores, con la salud que midió cada extremo y lo que cambió desde el período anterior.
- Capas de los equipos a los procesos y los servicios, con filtros por app, puerto, destino, problemas y cambios
- Cuando los dos extremos tienen agente, la vista del cliente y la del servidor de la misma conversación
- Los grupos de destinos, como un proveedor SaaS, en una sola caja
- Se abre desde cualquier equipo o grupo
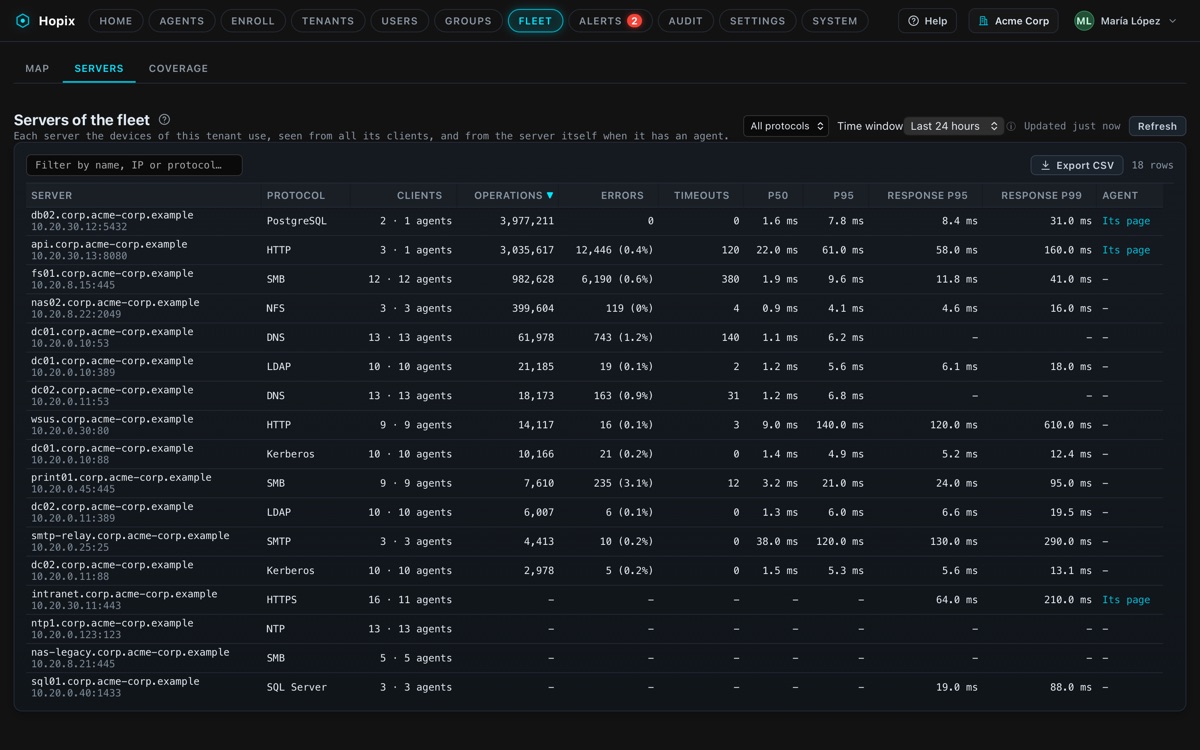
Servidores de la flota
¿Lento para todos o para una oficina?
Cada servidor que usan tus equipos, del servidor de archivos y los controladores de dominio a las bases de datos y las apps web internas, visto desde todos sus clientes a la vez, y desde el propio servidor cuando tiene agente.
- Clientes, operaciones, errores y timeouts de cada servidor y protocolo
- El tiempo de respuesta típico y el de las más lentas, medidos donde están los usuarios
- Un enlace a la página del propio servidor cuando corre un agente
- Filtros por protocolo y exportación a CSV
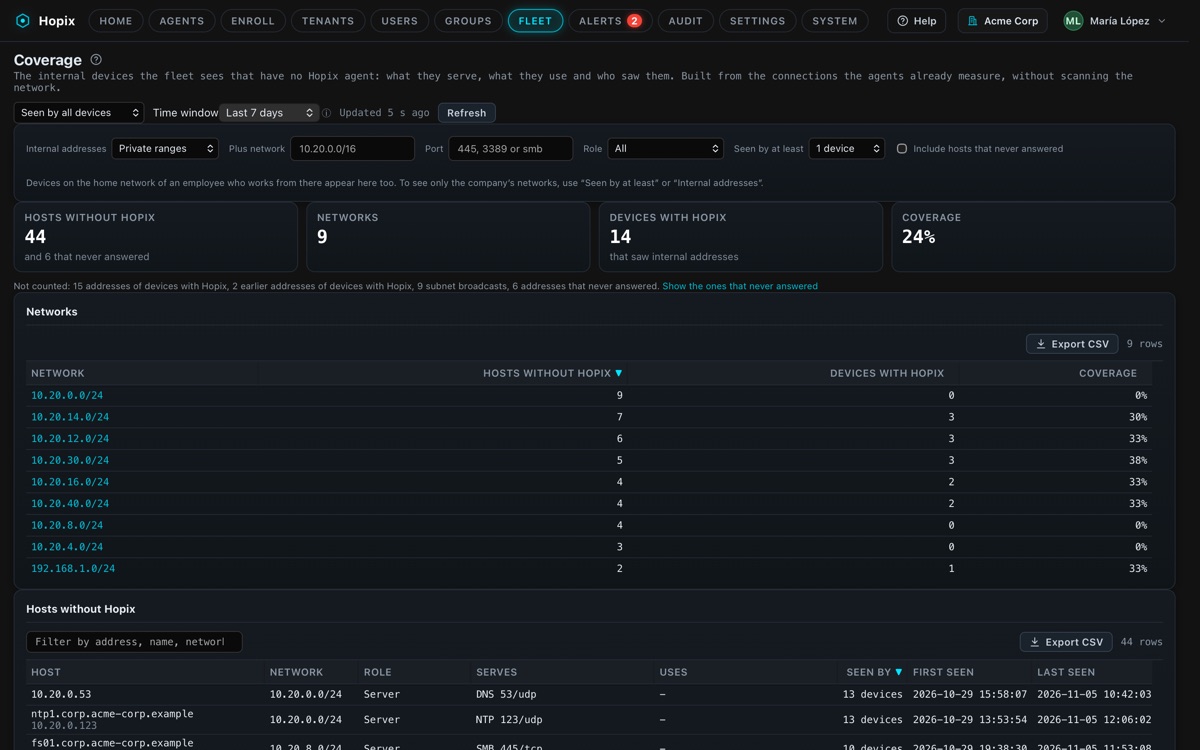
Cobertura
Los equipos que todavía no tienen agente
El informe de cobertura lista los equipos internos con los que habla tu flota y que no tienen el agente de Hopix, red por red, con cuántos de tus equipos ven a cada uno y los puertos que sirve o usa. Sale del tráfico que ya miden los agentes: nada escanea tu red.
- Cada red interna con sus equipos, con y sin agente
- Impresoras, servidores y equipos de red que usan tus equipos, con su nombre donde la flota lo conoce
- Para todo el tenant o un grupo
Los equipos remotos también ven las redes de sus casas: el informe deja mostrar solo las redes que ven varios equipos, o solo tus direcciones internas.
Alertas
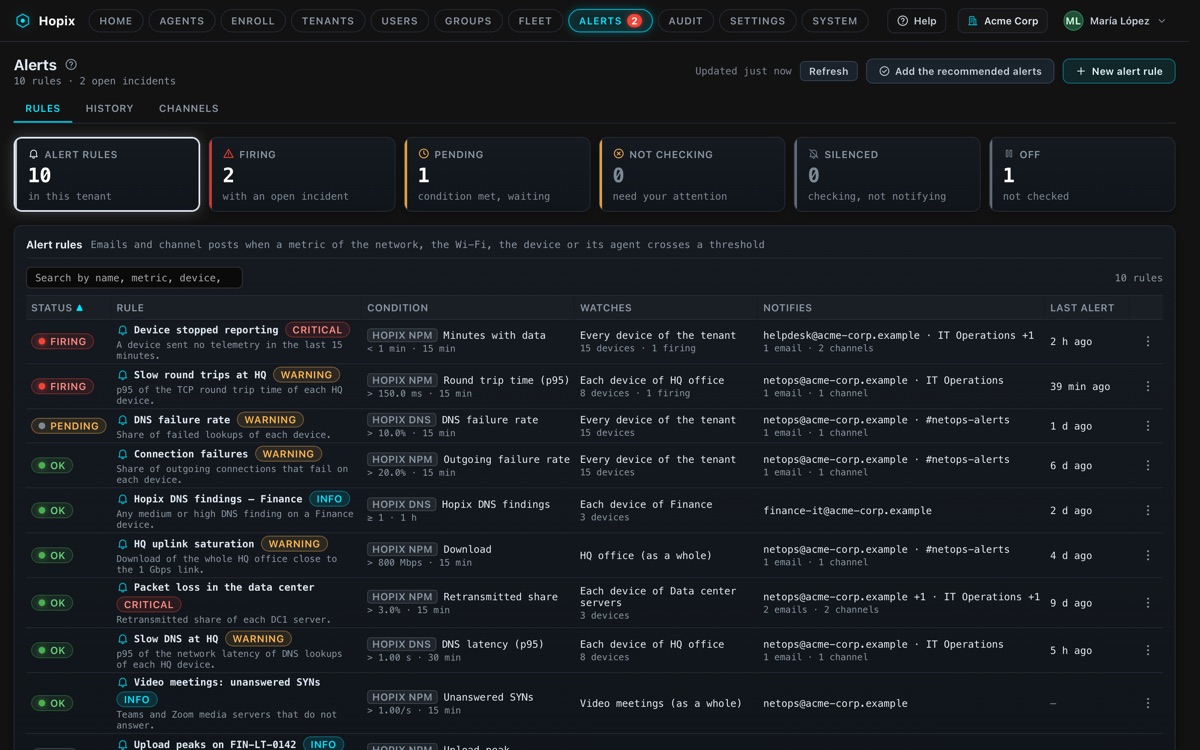
Alertas que llegan al canal correcto
Elige entre más de 60 métricas de NPM, protocolos, DNS, Wi-Fi, recursos del equipo y estado del agente, desde las conexiones fallidas y la tasa de errores de un protocolo hasta un Wi-Fi débil, un disco lleno o un agente desconectado, para un agente, un grupo entero o cada equipo de un grupo o del tenant.
- Plantillas listas y un paquete inicial recomendado
- Umbrales y rangos, una espera antes de disparar, muestras mínimas
- Incidentes con el primer, el peor y el último valor, reconocimiento e historial
- Correo, Microsoft Teams, Slack y webhooks firmados
- Silencio de hasta 7 días, nuevo aviso hasta que se reconozca
Grupos
Mira un sitio, un equipo o un servicio de una vez
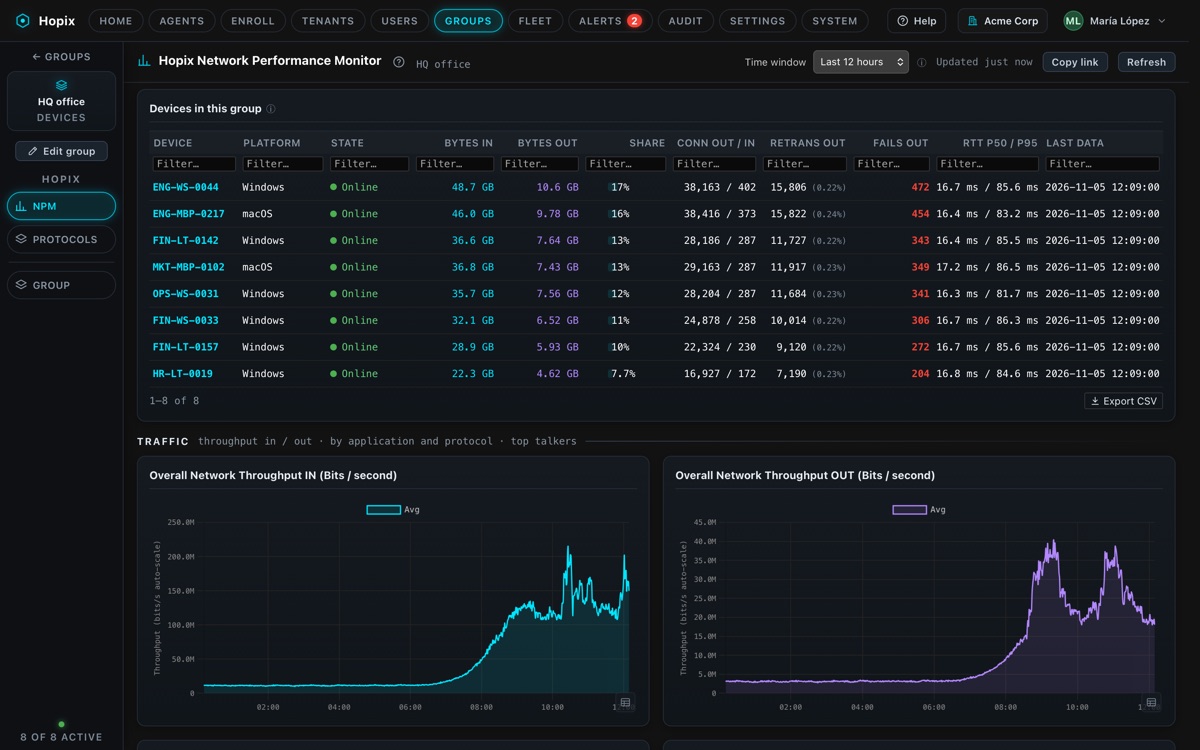
Agrupa equipos a mano o por reglas de hostname, usuario y dirección IP, agrupa el tráfico por puerto, o agrupa los destinos a los que llegan tus equipos: las redes y los dominios de un proveedor, un centro de datos o una app SaaS. Cada grupo tiene sus propias vistas de NPM, Protocolos y DNS, y puede disparar alertas.
- Reglas que cumplen alguna o todas sus condiciones
- Los equipos nuevos entran solos en los grupos que les corresponden
- Las vistas del grupo suman a sus miembros, con una tabla por equipo
- Grupos de destinos por red o por dominio, también para filtrar el tráfico de cualquier equipo
API y SIEM
Tus datos, en tus herramientas
Hopix encaja en las herramientas que ya usas: tus scripts y tableros, tus asistentes de IA y tu SIEM.
API de solo lectura
Lee los mismos valores que la consola desde tus scripts, tus tableros y tu herramienta de tickets.
- Agentes, vistas, hallazgos, grupos, alertas, incidentes y la auditoría
- Una API documentada y versionada, con su descripción OpenAPI
- Feeds de eventos de la auditoría y de las alertas
Servidor MCP
Deja que tus asistentes de IA respondan preguntas sobre tu red con tus datos de Hopix, en solo lectura.
- Los mismos datos que la API, con el mismo token
- Se habilita por token, nunca más de lo que puede ver su dueño
- Nada que pueda cambiar: sin escrituras ni comandos
Exportación al SIEM
Envía la auditoría y los eventos de las alertas a tu SIEM o tu plataforma de logs a medida que ocurren.
- Syslog con TLS, en JSON, CEF o LEEF
- HTTPS: un webhook firmado, Splunk HEC o Elastic
- El estado y el último error de cada destino, en la consola
Los tokens de la API los crea un administrador del tenant, leen solo ese tenant, nunca ven más que su dueño, se pueden limitar a tus redes, vencen en un año como mucho y se revocan en el acto. La API y el servidor MCP son parte del plan Enterprise; la exportación al SIEM, de Pro y Enterprise. Todos los planes exportan sus tablas a CSV, y un administrador del tenant puede exportar todos los datos del tenant en cualquier momento.
Inicio
Toda la flota de un vistazo
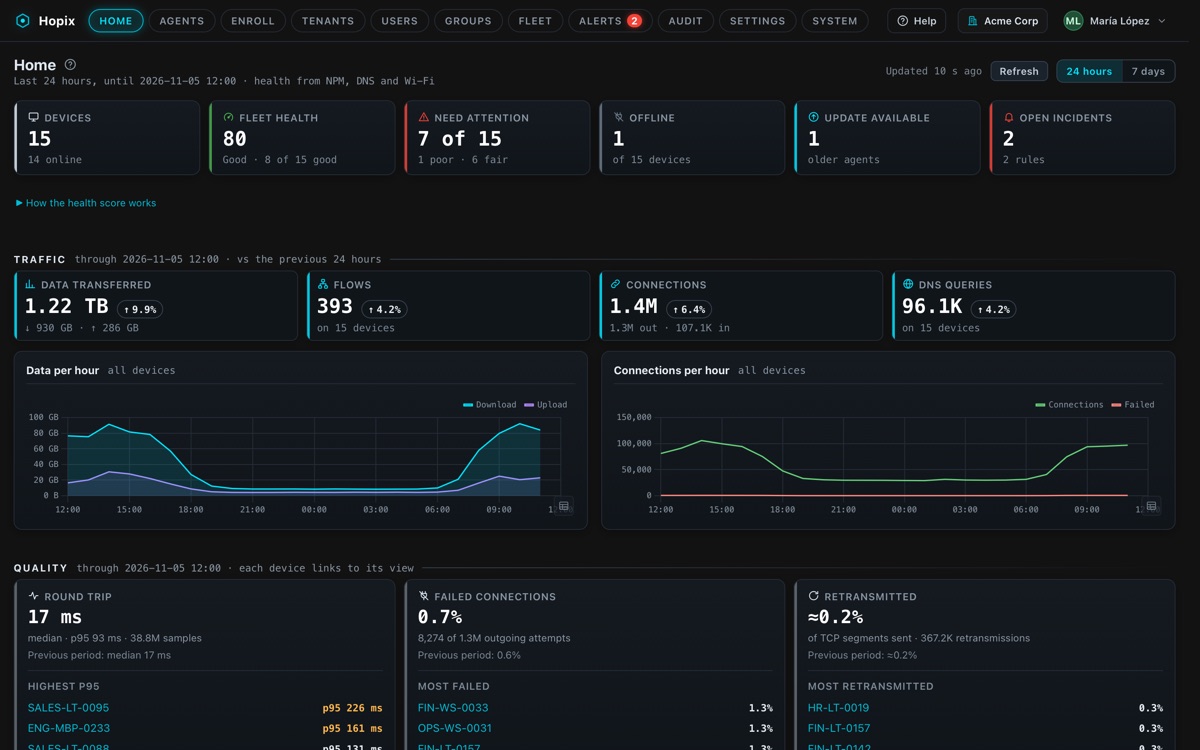
La consola se abre en tu flota: su tráfico y sus conexiones frente al período anterior, la calidad que midió cada equipo, lo más usado y lo que necesita atención ahora.
- Las últimas 24 horas o 7 días, frente al período anterior
- Un puntaje de salud de la flota y de cada equipo
- Ida y vuelta, conexiones fallidas, retransmisiones, descartes locales, fallas de DNS y señal Wi-Fi, con los equipos que peor están en cada una
- Los destinos, las aplicaciones y los protocolos más usados
- La salud de cada grupo, y los agentes por plataforma y versión
- Lo que necesita atención: equipos, incidentes abiertos, y las apps y los destinos con hallazgos
- Cada número lleva a la vista que lo explica
Gestión de la flota
Cada agente, gestionado desde la consola
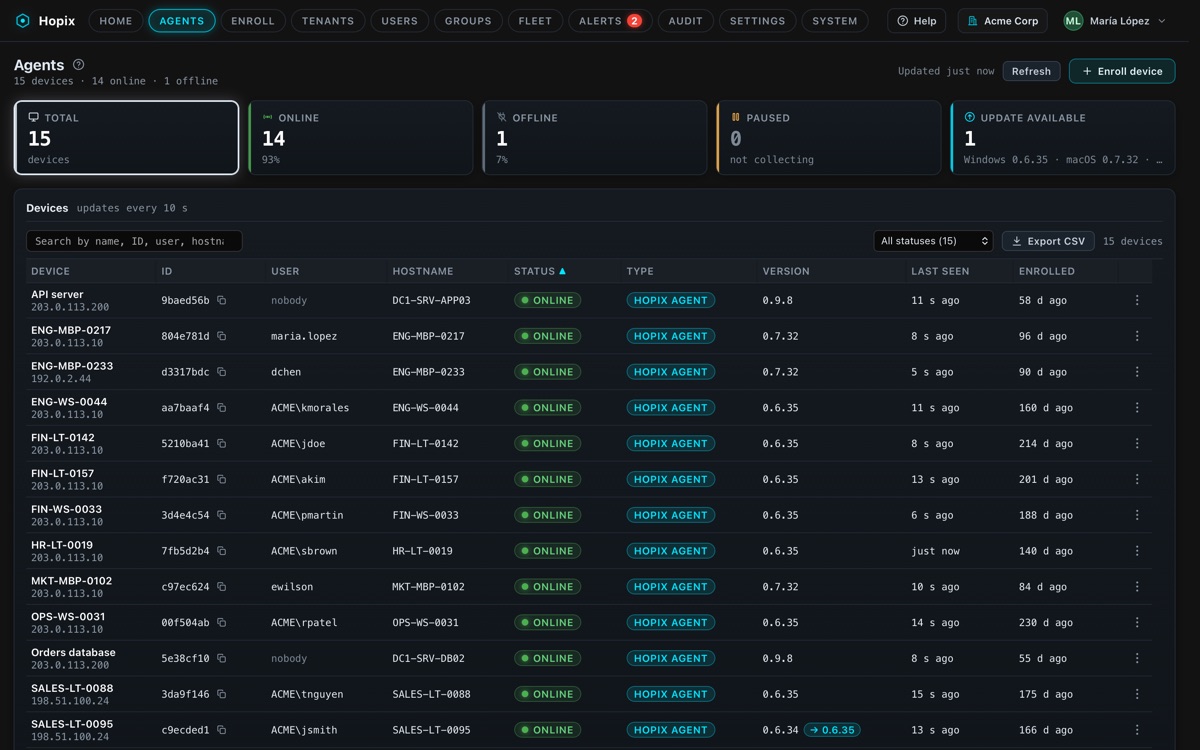
Instala con un comando por sistema, o desde tu RMM, una GPO, Intune o el MDM de tus Mac. Después actualiza, pausa, reinicia, reconfigura o desinstala cualquier agente a distancia, sin tocar el equipo.
- Primeros pasos que guían a un tenant nuevo del primer agente a la primera alerta
- Tokens de enrolamiento con límite de usos y vencimiento
- Reinstala un equipo sobre su registro y conserva su historial, o sobre uno nuevo que da de baja el anterior
- Un ID corto para cada agente, el mismo en la consola y en el equipo
- Actualizaciones automáticas firmadas con vuelta atrás
- Las fuentes de medición de cada agente, si están encendidas, en pausa o no disponibles, y por qué
- Ajustes por tenant o por agente, también el perfil de privacidad
- CPU, memoria, disco y procesos principales de cada equipo
Acceso
El control de acceso que espera tu equipo de seguridad
Conecta cada tenant a su proveedor de identidad, exige MFA y dale a cada persona solo las vistas que necesita.
- Inicio de sesión único SAML 2.0 por tenant: sus usuarios entran solo por su proveedor de identidad
- Acceso por los grupos de tu directorio: cada persona recibe los roles de sus grupos, y su cuenta se crea en su primer inicio de sesión
- Passkeys y apps de autenticación para las cuentas locales, y MFA obligatorio por tenant
- Roles de administrador del tenant y de los agentes, y privilegios separados para NPM, Radar y Wifi
- Invitaciones con un enlace de un solo uso: nadie elige la contraseña de otro
- Re-autenticación en las acciones sensibles, y sesiones que puedes ver y cerrar
- Auditoría de los inicios de sesión, los usuarios, los agentes, los comandos, los tokens de la API y los ajustes, exportada a tu SIEM
- Inglés y español, con el formato de números y la zona horaria de cada persona
- Una guía de usuario dentro de la consola, en inglés y en español, con búsqueda y un enlace de ayuda en cada vista
Agentes
Qué mide cada agente
Los tres agentes comparten una consola y un modelo de datos. Donde un sistema no expone algo, la consola muestra “No disponible” en vez de un cero.
| Función | Windows | macOS | Linux |
|---|---|---|---|
| Tráfico y conexiones (NPM) | Sí | Sí | Sí |
| Consultas DNS | Sí | Sí | Sí, salvo el DNS cifrado y el DNS sobre TCP |
| Tráfico por protocolo, como cliente y como servidor | Sí | Sí | Sí |
| Detalle de los protocolos: operaciones, códigos de error, tiempos de respuesta | Muchos: recursos compartidos, inicio de sesión, directorio, escritorio remoto, web, DNS, DHCP, SQL Server, administración remota y más | Algunos: web, TLS, QUIC, DNS, DHCP y recursos compartidos; más con los decodificadores opcionales | Algunos: recursos compartidos, servidores de inicio de sesión y de directorio, DNS, DHCP y SSH; más con los decodificadores opcionales |
| Tiempo de respuesta típico y de las más lentas, por protocolo y por servidor | Sí | Sí, de una muestra de las conexiones | Sí, de una muestra de las conexiones |
| Decodificadores de protocolos opcionales (apagados por defecto) | No: el detalle sale del propio Windows | 22 protocolos, más TLS y QUIC | 24 protocolos, más TLS y QUIC |
| Calidad de las llamadas (opcional, apagada por defecto) | No | No | Sí |
| Salud TCP: apertura de las conexiones, conexiones caídas por vencimiento, paquetes grandes perdidos en la ruta | Sí; la apertura, solo de las conexiones que abre el equipo | La apertura y los paquetes grandes perdidos en la ruta | Sí |
| Radar (ruta salto a salto) | Sí | Sí | Sí |
| Wi-Fi | Sí | Sí, sin el ID del punto de acceso (lo oculta macOS) | No |
| CPU, memoria, disco y procesos | Sí | Sí | Sí |
| Niveles de monitoreo | Los tres | Los tres | Los tres; solo eventos tiene requisitos adicionales del sistema |
| Contenido de los paquetes | Nunca se recolecta | Nunca se recolecta | Nunca se recolecta |
| Requisitos | Windows 10 u 11 de 64 bits | macOS 14+ en Apple silicon | x86-64, systemd: RHEL 9+, Ubuntu 22.04+, Debian 12+ |
Tres niveles de monitoreo
Completo, solo eventos o nada en el camino del paquete, para cada sistema o para un solo agente. Nuestro equipo fija el nivel que pidas, y la consola muestra el nivel de cada agente y lo que ese nivel deja afuera.
Cada fuente, bajo control
Cada fuente de medición tiene su propio interruptor y un costo medido, por sistema, y las nuevas llegan apagadas. Nuestro equipo las administra por ti, y la consola muestra qué fuentes corre cada agente.
Liviano en el equipo
En Windows y Linux, un guardián de CPU pausa las mediciones más detalladas antes de que pesen en el equipo: por defecto, cuando pasan del 5 % de un núcleo. Se reanudan solas.
Lo que cuesta cada agente, medidoMira Hopix en tu propia red
Agenda un recorrido de 30 minutos. Instalamos un agente contigo y miramos datos reales juntos.